AIにコードやドキュメントを触らせていると、素朴な疑問が湧いてきます。「AIがファイルを検索して回るこの方式は、どのくらいのファイル数まで実用的なのだろう?」「全部を探索させないためのフォルダ構成や、ドキュメントの置き方にコツはあるのだろうか?」
社内でこの話を掘っていった結果、行き着いた答えが少し意外でした。結局それは、大型汎用機の時代にバインダーで管理していた「要件定義書」の話だったのです。今回はその流れを、実務で使える形に整理して共有します。
まず事実確認:限界は「量」ではなく「ノイズ」
AIエディタやAIエージェントがコードを探すとき、裏側で使われているのは多くの場合、ripgrep のような高速な全文検索です。これ自体は数万ファイル規模でも数秒で終わる性能があり、純粋な処理速度がボトルネックになることはほとんどありません。
実用性を左右するのは、速度ではなく検索結果の質です。つまずくのはたいてい次の3つです。
- ヒット件数が多すぎる — ありふれた変数名や関数名で検索すると大量にヒットし、AIが結果を読み切れないまま、作業に使える情報量(コンテキスト)を食い潰してしまいます。
- 同名・類似名のファイルが散在している —
utilsのようなファイルが10か所にあると、どれが本命かを特定するために追加の探索が必要になります。 - 生成物や外部ライブラリが混ざっている — ビルド成果物や依存パッケージのフォルダが検索対象に入っていると、無駄なヒットが増えます。
体感としては、1つのリポジトリで数千〜1万ファイル程度までは特別な工夫なしでも快適に動く印象です。それを超える大規模な構成では、以下の工夫が効いてきます。
フォルダ構成でできること
1. 機能・ドメイン単位でまとめる
「画面の部品はここ、処理はここ、データ定義はここ」と役割の層ごとに横断的に分けるより、機能ごとに縦に束ねたほうが、AIにとっては断然探しやすくなります。認証に関わるファイルが1つのフォルダに揃っていれば、1回の検索やフォルダ一覧で必要な材料がまとめて手に入るからです。
2. 探索対象から除外する
バージョン管理の除外設定に加えて、エディタ側の検索除外設定でも生成物・ロックファイル・自動生成コードを外しておきます。AI向けの指示ファイルに「このフォルダは自動生成なので触らないこと」と一行書いておくのも効果があります。
3. 名前の一意性を上げる
index や utils ばかりの構成は、人間にもAIにも優しくありません。ファイル名だけで中身が推測できる名前にしておくと、検索結果の一覧を見た時点で候補を絞れるようになります。
いちばん効くのは「ドキュメントの置き方」
そして、もっとも効果が大きいのはここでした。AIに全探索させないための最強の武器は、構造をあらかじめ文章にしておくことです。
- ルートに全体像の地図を置く — フォルダ構成とそれぞれの役割、主要な入口となるファイルのパス、そして「認証まわりはこのフォルダ」といった“やりたいこと→場所”の対応表。これがあると、AIは探索の前にこの1枚を読み、狙いを絞った1〜2回の検索で目的地に着けます。
- 各フォルダにも短い説明を置く — 「このフォルダは何をするか」「主要ファイルはどれか」を数行。フォルダを開いた瞬間に迷わなくなります。
- 設計判断の記録を残す — 「なぜこの作りにしたか」を残しておくと、AIがその理由を推測するための余計な調査をしなくて済みます。
- 用語集をつくる — 社内の略語や独自の呼び名をまとめておくと、AIが正しいキーワードで検索できます。間違った用語で検索して空振りするのを防ぐ、地味に効く一手です。
要は、検索の回数を減らすというより、1回の探索の的中率を上げるという考え方です。
ここで気づく——「これ、要件定義書だ」
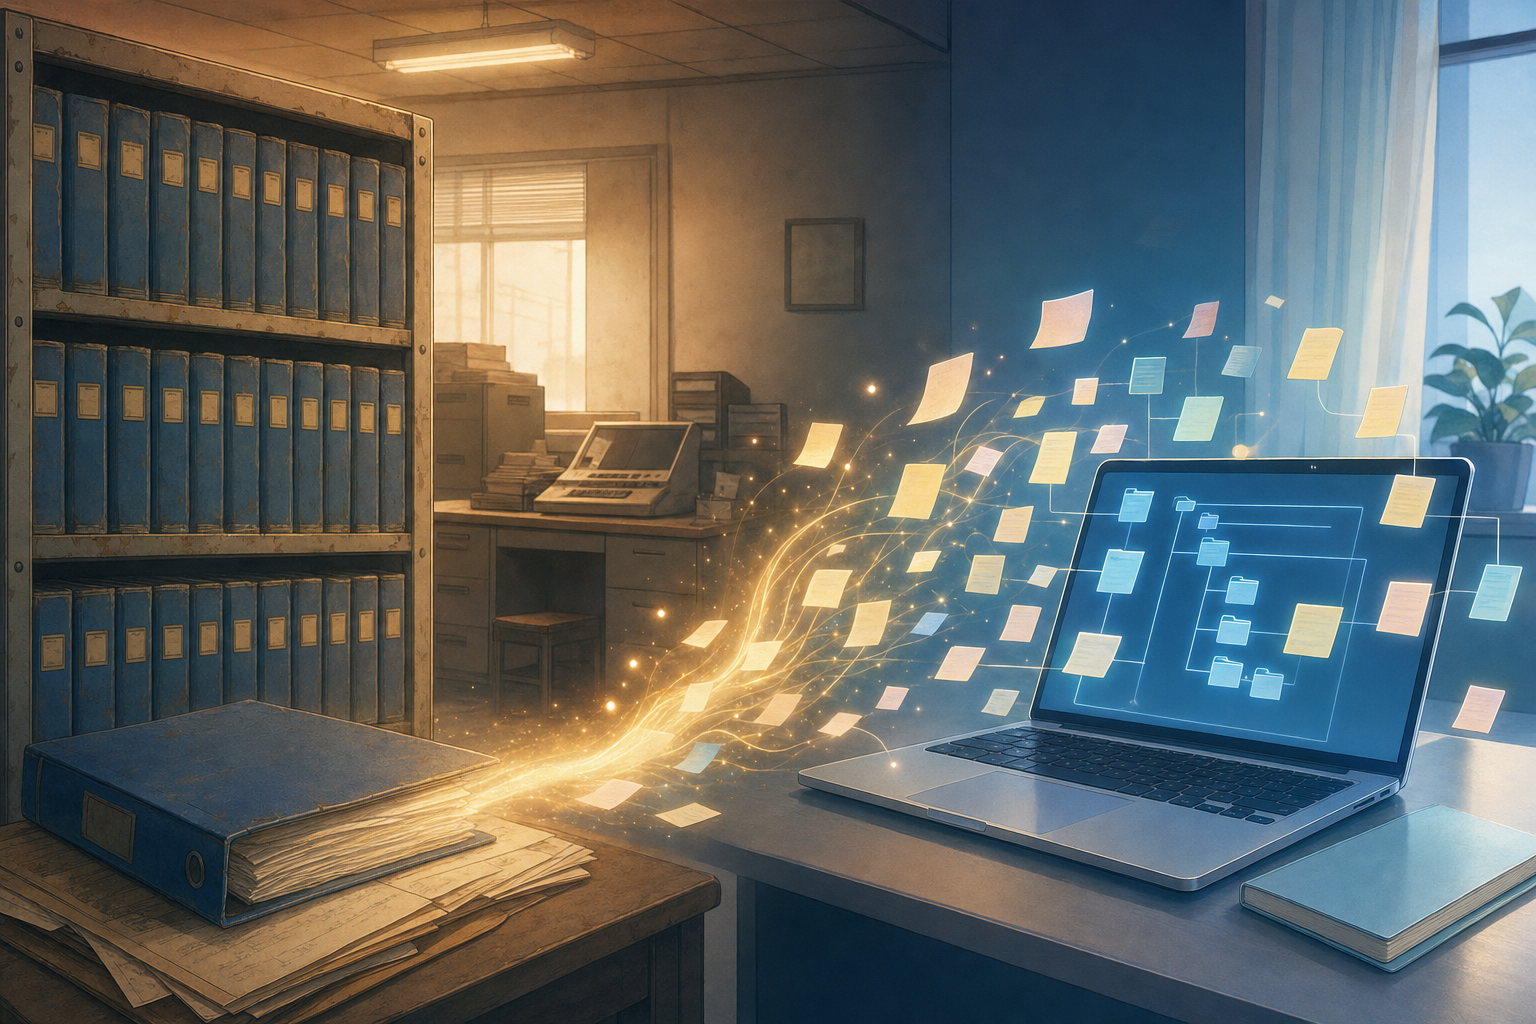
社内でここまで話したとき、こんな一言が出ました。「つまり昔ながらの要件定義書だね。大型汎用機時代の、青いバインダーに入れて書庫5段くらいあった、あれ」。
まさにそのとおりです。「ドキュメントを書くのは古い、動くコードこそ正義」という空気が長く続いた末に、AIが実務に入ってきた途端、構造化された仕様書の価値が再評価されているという流れになっています。
ただし、当時とは決定的に違う点が2つあります。
1. 「読む主体」が変わった
青バインダーの資料は人間が読むためのものでした。人間は多少の曖昧さや行間を読む力があります。一方でAIは、良くも悪くも書かれたとおりに読みます。「よしなに」「適宜」といった表現は、AIには届きません。昔以上に厳密で、構造化された書き方が求められるわけです。
2. 「更新されないと死ぬ」度合いが跳ね上がった
紙のバインダーは更新されなくても「古い資料だな」で済みました。しかしAIに読ませるドキュメントは、実装とズレていると間違った情報を積極的に注入して不具合を生みます。かつて「読まれない仕様書」は死蔵コストで済みましたが、いまや「間違った仕様書」は事故の原因になります。
そう考えると、いま起きているのは次のようなハイブリッドです。
大型汎用機時代の「書庫5段の要件定義書」の精神 × その後の軽量開発が培った「コードの隣に置く」作法
書庫5段ではなく、機能フォルダの隣に1枚ぺらを置く。分厚いバインダー1冊ではなく、薄い付箋を大量に散りばめる。思想は先祖返りしつつ、実装形態だけが軽量化された——ここが面白いところです。
生き返ったのは要件定義書だけではない
同じ理屈で、地味に評価が上がっているものが他にもあります。
- 命名規約・コーディング規約 — かつては「レビューで指摘されるから守る」程度の温度感でした。いまはAIが正しく推測できるかどうかに直結するため、守る動機がはるかに強くなっています。
- 単一責任の原則(関心の分離) — 1つのファイルが何十もの役割を抱えていると、AIも人間と同様に読み切れず、見当違いな修正をします。長年のお題目が、「守らないと実害が出る」という形で強制力を持ち始めました。
- 変更履歴・コミットメッセージの質 — 「なぜこの実装にしたか」を書き残す文化は、几帳面な人の余分な仕事と見られがちでした。いまはAIが過去の意図を復元するための貴重な情報源です。
つまり、人間のチームが働きやすくなるためのベストプラクティスは、そのままAIが働きやすくなるためのベストプラクティスでもあった、というのが今回の話の芯です。AIのために何かを新しく発明する必要はなく、ソフトウェア工学が数十年かけて磨いてきた知恵を、ちゃんと実践するだけでよかったわけです。
対策の一覧
| 対策 | 効果 |
|---|---|
| 機能単位のフォルダ構成 | 関連ファイルが物理的に近くなり、探索回数が減る |
| 検索除外設定の整備 | ノイズになるファイルを事前に外せる |
| 名前の一意化 | 検索結果のファイル名だけで候補を絞れる |
| ルートに全体像のドキュメント | 探索前に「地図」を渡せる |
| 各フォルダの短い説明 | フォルダ単位で迷子にならない |
| 設計判断の記録・用語集 | 「なぜ」「どの言葉で探すか」の推測コストを削減 |
まとめ
AIにコードを触らせるときの実用限界は、ファイルの数ではありません。AIが的を絞れるだけの案内が用意されているかです。そしてその案内の作り方は、システム開発が昔から積み上げてきた作法とほぼ同じものでした。
「効率化のために規約を破る」のではなく、「規約を守ることが結果的に一番の効率化になる」。原点回帰のようでありながら、AIという新しい読み手を迎えたからこそ、以前より切実な話になっています。長くシステム開発に携わってきた方の経験は、この時代にこそ効きます。
弊社では、こうした知見を自社サイトの再構築という実際の題材で検証しながら蓄積しています。AIを実務に組み込みたい、けれど何から整えればよいか分からない——そんなときは、まず「地図を書くところから」お手伝いします。